Le problème
Un entraîneur NBA répète la même consigne toute la saison : le tir se prend sous le cercle ou derrière la ligne à trois points, jamais entre les deux. Le tir en suspension à cinq mètres, celui qui faisait la signature du jeu des années 1990, ne représente plus que 10 % des tirs de la ligue.
Cette consigne repose sur un calcul, et le calcul se vérifie. Un tir à deux points rentre 54,7 % du temps, il rapporte donc 1,09 point en moyenne. Un tir à trois points rentre 36,4 % du temps et rapporte 1,09 point lui aussi. Les deux se valent, à la deuxième décimale près, et cette égalité ne dit rien du tir qu'un joueur s'apprête à prendre : ce qui compte, c'est l'endroit d'où il part, parce que l'endroit fixe à la fois la valeur du panier et la probabilité de le marquer.
La question est donc : combien rapporte un tir pris à tel endroit du terrain ? Le nombre existe déjà dans les données. Chaque tir passé a rapporté 0, 2 ou 3 points, et il suffit d'en faire la moyenne au bon endroit pour obtenir la valeur d'une position. On demande ensuite à un modèle de retrouver cette valeur à partir des seules coordonnées du tir.
Voilà les données. Une ligne par tir, les cinq premières de la table :
| player_name | shot_distance | loc_x | loc_y | shot_type | shot_made_flag | points |
|---|---|---|---|---|---|---|
| Dyson Daniels | 2 | −16 | 18 | 2PT Field Goal | 1 | 2 |
| Dyson Daniels | 2 | 20 | 20 | 2PT Field Goal | 0 | 0 |
| Nickeil Alexander-Walker | 26 | −123 | 231 | 3PT Field Goal | 0 | 0 |
| Asa Newell | 1 | 4 | 18 | 2PT Field Goal | 0 | 0 |
| Nickeil Alexander-Walker | 26 | 178 | 199 | 3PT Field Goal | 0 | 0 |
shot_distance est la distance au panier, en pieds. loc_x et loc_y donnent la position exacte du tir en dixièmes de pied, l'origine étant le panier : loc_x compte l'écart vers la gauche ou la droite, loc_y le recul vers le milieu du terrain. Ce sont les unités des données NBA ; on les convertit en mètres dès le chargement, et tout ce qui suit est en mètres. La colonne points vaut 0 si le tir est manqué, sinon 2 ou 3 selon le type : c'est la cible.
On travaille sur les 22 000 tirs que la table appelle l'échantillon de la ligue, pris par tous les joueurs, pour que la valeur d'une zone ne soit pas celle d'un joueur en particulier. Voici ce que chaque zone rapporte :
| zone | tirs | part des tirs | points par tir |
|---|---|---|---|
| sous le cercle | 6 199 | 28,2 % | 1,330 |
| corner gauche | 1 210 | 5,5 % | 1,250 |
| corner droit | 1 205 | 5,5 % | 1,225 |
| trois points au-dessus de l'arc | 6 764 | 30,7 % | 1,038 |
| raquette hors du cercle | 4 428 | 20,1 % | 0,905 |
| mi-distance | 2 194 | 10 % | 0,810 |
Un tir sous le cercle rapporte 1,33 point, un tir à mi-distance 0,81 point : le même geste rapporte 64 % de plus collé au panier qu'à cinq mètres. Et si on range ces zones par distance au panier, la valeur descend, remonte, puis redescend : 1,33 collé au cercle, 0,81 à mi-distance, 1,25 dans le corner à 6,7 mètres, 1,04 au-delà de l'arc, 0,84 passé 8,3 mètres.
Une régression linéaire ne peut pas représenter ça. Elle cherche une pente, donc une valeur qui monte ou qui descend régulièrement à mesure qu'on s'éloigne du panier, et elle ne peut pas faire les deux. Un arbre de décision (decision tree) le peut, parce qu'il ne cherche pas de pente : il découpe le terrain en régions et donne à chacune sa propre valeur.
Le concept et ce que tu vas apprendre
Un arbre de décision prédit en posant une suite de questions oui/non sur les variables, et donne sa réponse au bout du chemin. « Distance en dessous de 6,55 mètres ? » « Recul en dessous de 1,94 mètre ? » Deux réponses, et le modèle annonce un nombre de points.
On connaît déjà la bonne réponse, et c'est ce qui rend l'exercice vérifiable. La ligne à trois points est tracée sur le parquet : elle passe à 7,24 mètres du panier au-dessus de l'arc et à 6,71 mètres dans les corners. Le modèle, lui, ne reçoit que trois nombres par tir et n'a jamais entendu parler de cette ligne. S'il la retrouve, on le verra.
À la fin de ce module, tu sauras :
- lire un arbre entraîné et expliquer chacune de ses décisions à un entraîneur ;
- comprendre comment l'arbre choisit ses questions, et le recalculer à la main ;
- reconnaître les deux situations où un arbre bat une régression linéaire, la non-monotonie et l'interaction ;
- diagnostiquer le sur-apprentissage d'un arbre trop profond, et l'élaguer par validation croisée ;
- juger un modèle dont le R² est de 0,02 sans conclure trop vite qu'il ne vaut rien.
Les random forests et le boosting, qui viennent ensuite, assemblent des centaines de ces arbres.
La théorie en détail
Découper plutôt que tracer
Une régression linéaire pose une formule : tant de points par mètre de distance, tant par mètre d'écart latéral. Elle obtient une surface qui monte ou descend régulièrement, et elle ne peut rien faire d'autre.
Un arbre découpe. « Distance en dessous de 46 centimètres ? » sépare le terrain en deux régions. Dans celle des tirs plus lointains, on recoupe selon autre chose. À chaque question les régions rétrécissent, et chacune reçoit la moyenne des points rapportés par les tirs qui y tombent.
Rien n'oblige ces valeurs à se suivre dans un ordre. La région collée au panier vaut 1,49 point, la suivante 1,15, celle d'après 0,87, et la région du corner, bien plus loin du panier, 1,27. Une régression linéaire ne sait pas produire cette suite, et c'est pour ça que l'arbre est le premier modèle non linéaire du parcours.
Voici l'arbre dont on vient de parler, et les régions qu'il dessine.
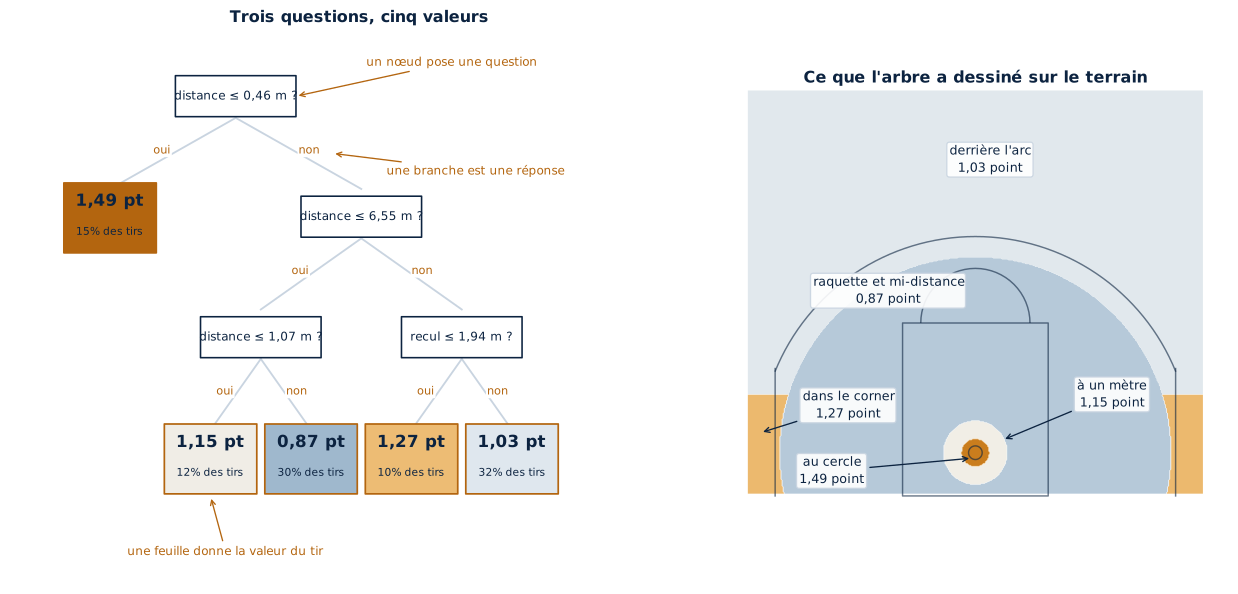
Le vocabulaire tient en trois mots, et le dessin les porte. Un nœud est une question. Une branche est une réponse, oui ou non. Une feuille est une région finale, qui porte la valeur prédite.
Le terrain de droite est le même arbre, vu d'en haut. Les cinq régions y sont des zones de basket que n'importe quel spectateur reconnaît : le cercle, son pourtour immédiat, la raquette et la mi-distance réunies, les deux corners, et le reste du terrain derrière l'arc. Personne n'a dessiné cette carte : elle sort de trois questions posées sur trois nombres.
Ce qu'une régression linéaire ne peut pas suivre
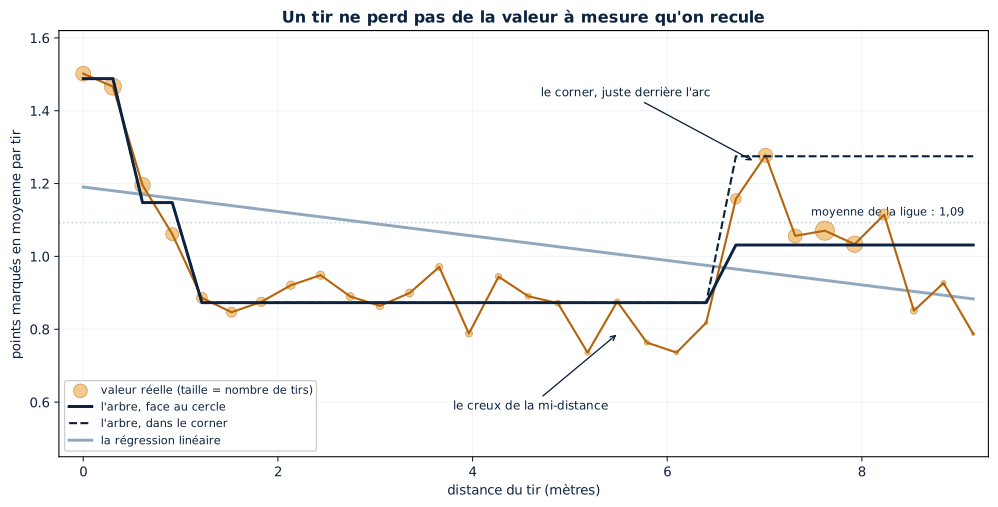
La courbe orange est la valeur réelle, mesurée distance par distance. Elle tombe dès qu'on s'éloigne du cercle, reste basse sur toute la zone à deux points, et remonte d'un coup au passage de la ligne à trois points. Puis elle redescend, parce qu'un tir de 9 mètres reste un tir à trois points mais devient beaucoup plus difficile.
La droite bleu clair est ce que la régression linéaire fait de ces mêmes données : elle descend de 1,19 à 0,88 entre le panier et 9 mètres. Elle n'est pas absurde, elle est seulement incapable de remonter, donc elle passe au-dessus de la mi-distance et en dessous des corners.
Les deux traits sombres sont l'arbre, qui suit la courbe par paliers. Il en produit deux différents selon qu'on se place face au cercle ou dans le corner, et la section suivante dit pourquoi.
À distance égale, deux valeurs différentes
Entre 6,4 et 7,1 mètres du panier, deux sortes de tirs se côtoient :
| tirs pris entre 6,4 et 7,1 mètres | nombre | points par tir |
|---|---|---|
| dans le corner gauche | 1 047 | 1,269 |
| dans le corner droit | 968 | 1,261 |
| à mi-distance | 153 | 0,660 |
Même distance, presque le double de valeur. La raison est géométrique : la ligne à trois points n'est pas un cercle. Elle est coupée par deux segments droits le long des lignes de touche, pour laisser passer les joueurs. Dans le corner elle passe donc à 6,71 mètres du panier, et ailleurs à 7,24 mètres. Un tir pris entre ces deux distances vaut donc trois points dans le corner et deux points partout ailleurs.
La valeur d'un tir ne dépend donc pas de la distance d'un côté et de l'angle de l'autre. Elle dépend de la combinaison des deux, et on appelle ça une interaction. Une régression linéaire ne la représente pas, sauf si un humain construit lui-même la variable qui la porte. Un arbre la découvre : il lui suffit de séparer d'abord sur la distance, puis, d'un seul côté de cette séparation, sur la position du tir le long du terrain.
Comment l'arbre choisit ses questions
L'arbre ne choisit pas au hasard. À chaque nœud il teste tous les splits possibles sur toutes les variables, un split étant un seuil qui partage les tirs en deux, et il garde celui qui rend les deux sous-groupes les plus homogènes.
Pour mesurer cette homogénéité quand la cible est un nombre, on utilise la variance : la moyenne des carrés des écarts à la moyenne du sous-groupe. Un sous-groupe dont tous les tirs rapportent la même chose a une variance nulle. Un sous-groupe où la moitié des tirs rapporte 0 et l'autre moitié 3 atteint la variance la plus forte possible.
Le gain d'un split est la variance du nœud moins la moyenne pondérée des variances des deux sous-groupes qu'il produit. L'arbre garde le split au plus fort gain, et recommence.
Quand la cible est une catégorie plutôt qu'un nombre, la mécanique est identique et seule la mesure change : on prend alors l'indice de Gini, 1 − Σ p_k², qui vaut 0 pour un sous-groupe d'une seule classe et monte quand les classes se mélangent.
L'algorithme CART
L'algorithme qui construit l'arbre dans scikit-learn s'appelle CART (Classification And Regression Trees), et trois traits suffisent à le décrire.
Il est récursif : une fois le premier split trouvé, il applique exactement la même règle à chacun des deux sous-groupes, puis aux sous-groupes de ceux-là, jusqu'à une condition d'arrêt.
Il est binaire : chaque question a deux réponses, jamais trois branches d'un coup.
Il est greedy : à chaque nœud il prend le meilleur split du moment, sans regarder si un split un peu moins bon maintenant ouvrirait de meilleures possibilités plus bas. Ce choix au coup par coup le rend rapide, mais il explique aussi pourquoi un arbre n'est jamais garanti optimal, et pourquoi il est sensible : si le premier split change, tous ceux du dessous changent aussi.
La profondeur, et le moment où l'arbre mémorise
Un arbre peu profond pose peu de questions et obtient des régions larges. Un arbre profond en pose beaucoup et finit par isoler des poignées de tirs dans des régions minuscules. À ce stade, il ne généralise plus, il mémorise : chaque région porte la moyenne de quelques tirs, et cette moyenne n'a plus rien à voir avec la valeur réelle de la position.
La profondeur (max_depth) est le réglage principal de cette flexibilité. On retrouve le compromis biais-variance du module 07 du parcours Data science, Généralisation et sur-apprentissage : trop peu profond, l'arbre sous-apprend ; trop profond, il sur-apprend. Sur ces tirs, le R² de test est au mieux à profondeur 4, puis il descend, passe sous zéro à profondeur 8 et tombe à −0,348 à profondeur 20.
Un R² négatif a un sens précis : le modèle fait moins bien que de prédire 1,09 point pour tous les tirs sans exception.
Un second réglage compte autant ici, min_samples_leaf : le nombre minimum de tirs dans une feuille. Il empêche l'arbre de fabriquer une région autour de vingt tirs dont quinze sont rentrés. Avec 1 500 tirs par feuille au minimum, chaque valeur affichée repose sur assez de tirs pour être crédible.
L'élagage
Fixer la profondeur au jugé fonctionne mal, parce que toutes les branches n'ont pas besoin de la même. L'élagage (pruning) fait l'inverse : on laisse l'arbre pousser sans limite, puis on coupe les branches dont l'apport ne justifie pas leur coût.
Le paramètre ccp_alpha fixe ce seuil : chaque feuille supplémentaire doit faire baisser l'erreur d'au moins ccp_alpha pour être conservée. Plus il est grand, plus on coupe. On le choisit par validation croisée, comme au module 08 du parcours Data science, Validation croisée.
Sur ces tirs, l'arbre poussé sans limite a 6 340 feuilles et un R² de test de −0,785. Élagué, il tombe à 6 feuilles et remonte à 0,024. Mille fois moins de feuilles, et un modèle qui prédit enfin mieux que la moyenne de la ligue.
Juger un modèle dont le R² vaut 0,02
L'arbre élagué obtient un R² de 0,024 par tir. Pris seul, ce nombre ressemble à un échec.
Il ne l'est pas, et la raison tient au basket. Un tir rentre ou ne rentre pas. À l'endroit le plus favorable du terrain, sous le cercle, un tir sur trois est manqué. Personne, avec aucun modèle et aucune donnée, ne peut prédire le résultat d'un tir précis : ce qui se prédit, c'est une moyenne sur beaucoup de tirs, et la part de la variation d'un tir individuel qu'on peut expliquer par sa position est minuscule par construction.
Le plafond se mesure, il ne se suppose pas. On donne à un modèle la valeur réelle de chacune des six zones officielles de la NBA, apprise sur les données d'entraînement, et on regarde son R² par tir : 0,021. L'arbre fait 0,024. Il fait donc mieux que les six zones que la ligue utilise pour découper le terrain, avec trois nombres et aucune connaissance du basket.
Le R² par tir n'est donc pas la bonne mesure pour cette tâche. Trois questions comptent davantage :
- l'arbre range-t-il les zones dans le bon ordre ?
- de combien se trompe-t-il sur la valeur d'une zone ?
- si une équipe choisissait ses tirs en suivant le modèle, combien marquerait-elle ?
Ces trois questions ont des réponses chiffrées, et elles séparent nettement l'arbre de la régression linéaire.
Pièges à connaître
- L'instabilité. Change quelques milliers de tirs d'entraînement et l'arbre peut retenir un autre premier split, donc une structure différente. Un seul arbre est fragile, et c'est exactement ce que le random forest corrige au module suivant.
- L'importance des variables décrit un arbre, pas les données. Les
feature_importances_de scikit-learn se calculent à partir de la baisse d'impureté, ce qui favorise les variables à beaucoup de valeurs distinctes et celles que l'arbre a utilisées en premier. L'arbre à trois questions donne 0,895 à la distance, 0,105 au recul et 0,000 à l'écart latéral, alors que l'arbre élagué sépare deux fois sur cet écart latéral. Une importance nulle ne veut pas dire qu'une variable ne sert à rien. - L'illusion de l'entraînement. L'arbre sans limite atteint 0,785 sur ses propres données. C'est le signal du sur-apprentissage, pas une performance.
- Pas d'extrapolation. L'arbre prédit par régions. Au-delà de la plage des tirs qu'il a vus, il répète la valeur de la dernière feuille au lieu de prolonger une tendance.
Le code
On charge les tirs, on convertit les distances en mètres, on calcule ce que chaque tir a rapporté, et on regarde ce que valent les zones et les distances. La colonne suivi vaut 1 pour les sept joueurs dont la table contient tous les tirs ; on les écarte pour ne garder que l'échantillon de la ligue.
La ligue rentre 54,7 % de ses tirs à deux points et 36,4 % de ses tirs à trois : les deux types rapportent le même 1,09 point en moyenne, et cette moyenne est la seule chose qu'ils ont en commun.
La colonne des valeurs par distance descend de 1,330 à 0,782, remonte à 1,220, puis redescend à 0,838. Deux changements de sens : une régression linéaire en rate forcément un.
Le dernier bloc isole les tirs pris entre 6,4 et 7,1 mètres. Dans les corners ils rapportent 1,269 et 1,261 point ; à mi-distance, à la même distance du panier, 0,660 point. Les 14 tirs que la table classe au-dessus de l'arc à cette distance viennent de l'arrondi : shot_distance est donnée au pied près.
On entraîne maintenant l'arbre de la figure. Trois variables seulement, la distance et les deux coordonnées, et deux garde-fous : trois questions au maximum, et jamais moins de 1 500 tirs dans une feuille.
Cinq feuilles, et chacune est une zone de basket que tout le monde reconnaît.
Collé au panier, en dessous de 46 centimètres, un tir rapporte 1,49 point : c'est le dunk et le lay-up. De 46 centimètres à 1,07 mètre, 1,15 point. De 1,07 à 6,55 mètres, 0,87 point, et cette seule région couvre 30 % des tirs de la ligue, toute la raquette et toute la mi-distance confondues.
Au-delà de 6,55 mètres, l'arbre pose une deuxième question, sur y cette fois : le tir est-il à moins de 1,94 mètre du niveau du panier ? Si oui, 1,27 point ; si non, 1,03 point.
Cette dernière question est la définition du corner. Et le seuil de 6,55 mètres est la ligne à trois points, que l'arbre place entre les 6,71 mètres du corner et les 7,24 mètres du reste de l'arc. Personne ne lui a dit qu'une telle ligne existait.
Vérifions d'où vient ce seuil. On se place là où l'arbre pose sa deuxième question, donc parmi les tirs au-delà de 46 centimètres, on teste tous les seuils de distance un par un, et on calcule le gain de chacun à la main.
Le graphique monte régulièrement jusqu'à 6,5 mètres, puis s'effondre : 0,0046 de gain à 6,5 mètres, 0,0004 à 7,1 mètres, dix fois moins pour 60 centimètres de plus. C'est le comportement d'une frontière nette, pas d'une tendance progressive. L'arbre n'a rien deviné, il a essayé les trente seuils et gardé le meilleur.
Les gains sont petits en valeur absolue parce que la variance de départ est énorme : 1,54, pour une cible qui vaut 0, 2 ou 3.
Passons au sur-apprentissage. On fait varier la profondeur et on regarde l'écart entre l'entraînement, le test et la validation croisée.
Les deux courbes partent ensemble et se séparent à partir de la profondeur 4. L'entraînement monte de 0,0195 à 0,3504 pendant que le test descend de 0,0216 à −0,3482. À profondeur 20, l'arbre a 2 773 feuilles et prédit plus mal que la moyenne de la ligue.
L'écart entre les deux courbes est la quantité de bruit que l'arbre a appris par cœur. Il se creuse feuille après feuille.
Plutôt que de fixer la profondeur au jugé, laissons l'arbre pousser sans limite et élaguons-le.
De 6 340 feuilles à 6, et le R² de test passe de −0,785 à 0,024.
L'arbre élagué prédit mieux que celui de la cellule 02, et il ne sépare pas au même endroit. Il commence à 46 centimètres, comme avant. Ensuite il sépare sur x, deux fois : à −6,78 mètre puis à +6,84 mètres. Ce sont les deux lignes des corners, à 6,71 mètres du panier de chaque côté du terrain. Il les a trouvées séparément, parce que rien ne lui dit qu'un terrain de basket est symétrique. Enfin, pour les tirs entre les deux, il sépare à 7,16 mètres : la ligne à trois points au-dessus de l'arc, tracée à 7,24 mètres.
L'arbre à trois questions confondait ces deux lignes en une seule à 6,55 mètres. Celui-ci, laissé libre puis élagué, les sépare. Les valeurs qu'il produit sont 1,49 collé au cercle, 1,27 dans le corner gauche, 1,25 dans le corner droit, 1,15 autour d'un mètre, 1,03 au-delà de l'arc et 0,87 partout ailleurs.
Reste à le comparer à une régression linéaire, et à le juger sur autre chose que le R² par tir.
Le tableau des zones se lit ligne par ligne. La colonne reel donne l'ordre véritable, du cercle à 1,317 jusqu'à la mi-distance à 0,844. L'arbre le respecte. La régression linéaire, elle, prédit 1,124 pour la raquette et 1,093 pour la mi-distance, contre 0,970 pour les trois points au-dessus de l'arc : elle affirme qu'un tir à mi-distance vaut plus qu'un tir à trois points. La réalité est exactement l'inverse, 0,844 contre 1,038.
Ce n'est pas une nuance de calcul. Une équipe qui réglerait sa sélection de tirs sur ce modèle reviendrait à la mi-distance, c'est-à-dire au tir que la ligue a passé quinze ans à sortir de son jeu.
L'erreur moyenne sur la valeur d'une zone est de 0,023 point pour l'arbre et de 0,126 point pour la régression linéaire, cinq fois plus. Et si l'on ne gardait que les 10 % de tirs que chaque modèle juge les meilleurs, ceux de l'arbre rapporteraient 1,467 point contre 1,277, quand la moyenne du jeu de test est de 1,090.
Quant au R² par tir, l'arbre est à 0,0242 et la régression linéaire à 0,0044. Le modèle à qui l'on a donné les six zones officielles de la NBA est à 0,0208 : l'arbre passe devant, sans rien connaître au basket.
Le dernier bloc répond à une objection légitime : une régression linéaire peut-elle s'en sortir si on lui donne la bonne variable ? En ajoutant le carré de la distance, son R² passe de 0,0044 à 0,0125. En ajoutant plutôt un indicateur qui vaut 1 pour les tirs à trois points, il monte à 0,0178. Elle progresse donc beaucoup, et elle reste sous l'arbre.
Surtout, il a fallu savoir d'avance quelle variable construire, c'est-à-dire connaître la réponse avant de poser la question. C'est le sujet du module 12 du parcours Data science, Ingénierie des variables. L'arbre, lui, n'a eu besoin de personne.
À toi de jouer
Refais l'arbre de la cellule 02 en remplaçant d['suivi'] == 0 par d['player_name'] == 'Stephen Curry', puis par 'Rudy Gobert'. Tu obtiendras deux cartes du terrain très différentes, et l'une des deux perd une question. Descends min_samples_leaf à 150, sans quoi un joueur qui prend 800 tirs dans la saison n'autorise aucun split. Puis compte combien de tirs chacun prend derrière l'arc avant de conclure.
Deuxième piste : ajoute period et minutes_remaining aux variables de la cellule 05, relance l'élagage, et regarde si l'arbre juge le moment du match assez informatif pour séparer dessus. Compare le R² de validation croisée avant et après.
Conclusion
Un arbre de décision a reçu trois nombres par tir, une distance et deux coordonnées, sans aucune notion de basket. Il en a sorti une carte du terrain qui place la ligne à trois points à 6,8 mètres dans les corners et à 7,16 mètres ailleurs, et qui range les zones dans le même ordre que les données. Une régression linéaire, sur ces mêmes trois nombres, conclut qu'un tir à mi-distance vaut plus qu'un tir à trois points.
La différence ne vient pas de la puissance de calcul mais de la forme du problème : la valeur d'un tir monte, descend et remonte, et elle dépend de la combinaison de la distance et de l'angle plutôt que de chacun séparément.
Ce que tu as appris
- Un arbre de décision prédit par une suite de questions oui/non et découpe l'espace en régions, chacune portant sa propre valeur. C'est un modèle non linéaire et lisible.
- Il choisit ses splits en réduisant l'impureté : la variance quand la cible est un nombre, l'indice de Gini quand c'est une catégorie. À chaque nœud, il teste tous les seuils et garde le meilleur.
- Il bat une régression linéaire dans deux situations, et ce sont les deux qu'on a mesurées ici : la non-monotonie et l'interaction.
- La profondeur règle la flexibilité. Trop grande, l'arbre mémorise : 0,350 en entraînement et −0,348 en test à profondeur 20. L'élagage par
ccp_alpharamène 6 340 feuilles à 6 et le test de −0,785 à 0,024. - Un R² faible ne suffit pas à condamner un modèle. Il faut connaître le plafond de la tâche et choisir une mesure qui répond à la question posée : ici l'ordre des zones, l'erreur sur la valeur d'une zone, et les points récoltés sur les meilleurs tirs.
Ce que ça change pour le basket
La carte que l'arbre produit est celle que les équipes NBA appliquent depuis quinze ans : tirer sous le cercle, tirer dans les corners, prendre le reste de ses trois points au-dessus de l'arc, et ne pas s'arrêter à cinq mètres. La mi-distance est tombée à 10 % des tirs de la ligue, et un modèle qui reçoit trois coordonnées retrouve pourquoi en trois questions.
L'intérêt pratique est là : la règle se lit, donc elle se discute avec un entraîneur, qui peut la contester ou la nuancer. Un coefficient de régression ne s'affiche pas au tableau d'un vestiaire ; un découpage du terrain, si.
Ce qui vient ensuite
Un seul arbre reste fragile : change quelques milliers de tirs et sa structure peut basculer. La suite consiste à en construire des centaines, chacun sur un échantillon différent, et à moyenner leurs réponses. Le prochain module construit une random forest et montre, formule de la variance à l'appui, pourquoi la moyenne de modèles instables devient stable.