Le problème
Tu connais le nombre de points d'un joueur une fois le match fini. Mais peux-tu le prédire avant ? Un directeur sportif qui hésite à signer un joueur se pose exactement cette question : « vu ce qu'il produit, combien va-t-il marquer la saison prochaine, et quelle valeur lui donner ? » Il regarde des centaines de joueurs passés, repère ce qui va ensemble, et en tire une estimation. C'est précisément ce qu'un modèle d'apprentissage automatique fait, mais en chiffres et sans intuition. Avant d'écrire la moindre ligne de modèle, posons ce que veut dire « prédire ».
Le concept et ce que tu vas apprendre
L'apprentissage supervisé consiste à laisser un programme apprendre une relation à partir d'exemples, au lieu de la lui dicter par des règles écrites à la main.
On ne programme pas « si le joueur tente beaucoup de tirs, alors beaucoup de points ». On montre au modèle des centaines de joueurs réels, avec à chaque fois la bonne réponse, et il en déduit lui-même la relation. C'est la grande bascule par rapport à la programmation classique : là où un développeur écrit la règle, ici on fournit des données et le modèle écrit la règle pour nous.
À la fin de ce module, tu sauras :
- ce qu'est exactement l'apprentissage supervisé, et en quoi il diffère d'un programme à base de règles ;
- nommer les variables explicatives (X) et la cible (y) d'un problème NBA ;
- distinguer prédiction et inférence, supervisé et non supervisé ;
- comprendre pourquoi un modèle appris bat une règle de bon sens, et où sont ses limites (l'erreur qu'aucun modèle ne fait disparaître, et la généralisation qu'on travaillera ensuite).
C'est le socle du parcours. Tous les modules suivants sont des variations sur cette idée.
La théorie en détail
L'intuition : une fonction qui transforme ce qu'on sait en ce qu'on cherche
Fixons le vocabulaire de base. Il revient dans chaque module, autant le poser proprement maintenant.
- une observation : une ligne de données, un exemple. Ici, un joueur sur une saison.
- une variable explicative (feature, l'entrée, qu'on note X) : ce qu'on connaît et qui sert à prédire. Ici, le nombre de tirs tentés par match.
- la cible (target, la sortie, qu'on note y) : ce qu'on cherche à prédire. Ici, les points par match.
- un modèle : une fonction qui transforme X en une estimation de y. On l'écrit
y ≈ f(X).
Voici à quoi ressemblent six lignes de la table qu'on va utiliser, player_season.csv, une ligne par joueur et par saison :
| player_name | fga_pg | ft_pg | min_pg | ppg |
|---|---|---|---|---|
| A.J. Lawson | 2,2 | 0,4 | 9,4 | 2,9 |
| AJ Johnson | 2,4 | 0,5 | 9,4 | 2,2 |
| Aaron Gordon | 10 | 3,1 | 27,9 | 14,6 |
| Aaron Holiday | 3,1 | 0,4 | 13,7 | 3,9 |
| Aaron Nesmith | 9,1 | 1,6 | 29,7 | 11,1 |
| Aaron Wiggins | 7,5 | 0,7 | 21,8 | 8,6 |
Chaque ligne est une observation. La colonne fga_pg (tirs tentés par match) sera notre X, la colonne ppg (points par match) notre y. Les autres colonnes existent et serviront plus tard.
Le f de y ≈ f(X) est simplement la règle de calcul que le modèle finit par adopter. Le X, lui, désigne l'ensemble des variables explicatives qu'on accepte de lui donner, une par colonne. Ici il n'y en a qu'une, les tirs tentés, donc f se réduit à « multiplie les tirs par un nombre, puis ajuste ». Dès le module suivant, X en contiendra six ou sept, et f pèsera chaque statistique séparément : tant de points par tir tenté, tant par minute jouée, tant par année d'expérience. Le principe ne change pas, seule la largeur de X change.
Géométriquement, apprendre revient à tracer la « bonne » courbe à travers un nuage de points. Chaque joueur est un point (ses tirs en abscisse, ses points en ordonnée). Le modèle cherche la fonction f qui passe au plus près de tous ces points à la fois. Une fois cette fonction trouvée, prédire pour un joueur nouveau, c'est lire la hauteur de la courbe à l'endroit de ses tirs.
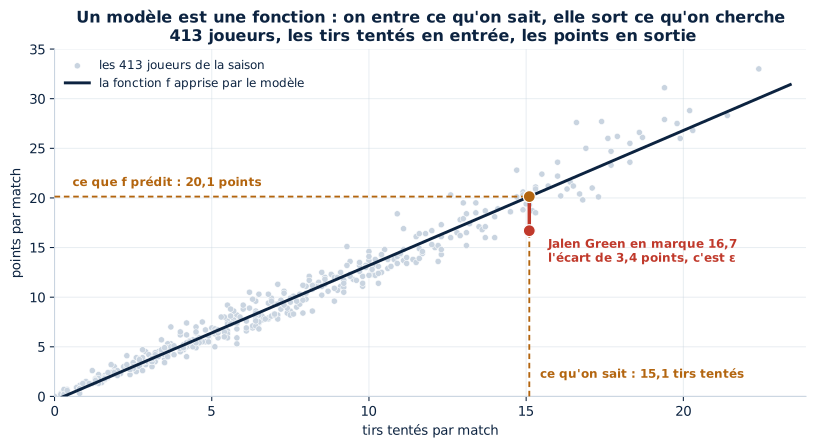
Cette courbe se lit comme un barème. À 15 tirs par match, elle annonce 20 points : c'est ce que produit un joueur ordinaire de la ligue avec ce volume de tirs. Les joueurs qui s'en écartent franchement sont les cas intéressants. Au-dessus de la droite, ceux qui marquent plus que leur volume de tirs ne le laissait attendre, souvent grâce aux lancers francs ou à l'adresse à 3 points. En dessous, ceux qui tentent beaucoup pour peu de points, comme Jalen Green sur cette saison : 15,1 tirs par match pour 16,7 points, quand la droite en prévoyait 20,1.
Le modèle contre la règle écrite à la main
Pour sentir l'intérêt, opposons deux approches sur la même question : « combien de points pour un joueur à 15 tirs ? »
- La règle écrite à la main. Un fan dirait : « un tir, c'est à peu près un point, donc 15 tirs font 15 points ». Le raisonnement se tient : un tir réussi à deux points en rapporte deux, et comme un joueur en réussit environ un sur deux, on retombe sur un point par tir tenté. Sauf que cette règle oublie les lancers francs et les paniers à 3 points, qui ajoutent des points sans ajouter de tirs tentés dans la même proportion. C'est une règle figée, choisie par un humain, et elle sous-estime systématiquement.
- Le modèle appris. On ne choisit pas la règle. On donne au programme 413 joueurs réels et on le laisse trouver, tout seul, le lien tirs → points qui colle le mieux aux données. Tu verras dans le code qu'il trouve plutôt « 1 tir ≈ 1,36 point », et que cette relation se trompe en moyenne de moins d'un point, contre plus de deux pour la règle naïve.
Cette différence devient décisive dès qu'on change d'échelle. Quand on aura vingt variables (taille, poste, minutes, efficacité), aucun humain ne saura écrire à la main la règle qui les combine. Le modèle, lui, l'apprendra à partir des exemples.
L'erreur qui reste, et ce que le modèle minimise
Deux joueurs qui tentent exactement 15 tirs ne marquent pas le même nombre de points, et aucune colonne de notre table ne comblera cet écart. On écrit donc honnêtement :
y = f(X) + ε
où ε (epsilon) est l'erreur irréductible : tout ce que les variables disponibles ne peuvent pas expliquer. La forme du soir, la qualité de la défense adverse, un shoot qui rentre au buzzer. Même le modèle parfait laisse un ε. Viser ε = 0, ce serait apprendre par cœur le bruit de cette saison précise, pas la vraie tendance. On reviendra longuement là-dessus : c'est le piège du sur-apprentissage.
Comment le modèle choisit-il son f ? Il essaie de rendre ses erreurs aussi petites que possible. Pour chaque joueur, il compare sa prédiction à la vraie valeur ; l'écart est le résidu. Le modèle cherche la fonction qui minimise ces résidus dans leur ensemble. Tu n'as pas besoin de la formule exacte ici (c'est le module « Comment un modèle apprend »), mais le principe tient en une ligne : apprendre, c'est réduire l'écart entre prédiction et réalité sur les exemples connus. C'est de là que sort le « 1,36 point par tir » : ce n'est pas un chiffre choisi, c'est celui qui minimise l'erreur sur les 413 joueurs.
Supervisé ou non supervisé : la première question à se poser
Deux grandes familles, et reconnaître laquelle on traite est la toute première décision d'un projet.
- Apprentissage supervisé : on dispose de la bonne réponse (la cible y) pour chaque exemple d'entraînement. Le modèle apprend en comparant ses prédictions aux vraies valeurs. Prédire les points d'un joueur est supervisé, puisqu'on connaît les points des saisons passées. Estimer le salaire qu'un profil devrait valoir l'est aussi, parce que les salaires réels sont dans la table. C'est l'essentiel de ce parcours.
- Apprentissage non supervisé : il n'y a pas de cible. On cherche une structure cachée. Regrouper les 413 joueurs en familles de jeu sans décider d'avance lesquelles est non supervisé, et résumer une vingtaine de statistiques en deux ou trois axes qui séparent les intérieurs des extérieurs l'est aussi. On y viendra dans le parcours machine learning (ACP, clustering).
Une image pour fixer la distinction : le supervisé, c'est réviser avec le corrigé sous les yeux ; le non supervisé, c'est ranger une bibliothèque sans catalogue, en regroupant ce qui se ressemble.
Prédire ou comprendre
Même en supervisé, on peut viser deux choses différentes, et ça change la façon de travailler.
- la prédiction : obtenir une bonne estimation de y pour un nouveau cas, sans forcément expliquer pourquoi (« ce joueur marquera environ 20 points »).
- l'inférence : comprendre comment les variables influencent la cible (« chaque tir supplémentaire rapporte environ 1,36 point »).
Les deux sont légitimes. Un bookmaker veut prédire le plus juste possible, peu importe le mécanisme. Un directeur sportif veut souvent comprendre, parce qu'il doit justifier une décision et la transposer à d'autres joueurs.
Le réglage qui compte ici, et les diagnostics
Une seule décision compte ici, et ce n'est pas un réglage technique : sur quels joueurs mesure-t-on l'erreur ? Si on la mesure sur ceux qui ont servi à l'apprentissage, le modèle note son propre travail. Il peut sembler excellent simplement parce qu'il a déjà vu ces joueurs.
L'équivalent basket est facile à voir. Un recruteur qui se juge en relisant les joueurs qu'il a déjà signés se donnera toujours raison. Son œil ne se mesure que sur des joueurs qu'il n'a jamais évalués. Pour le modèle, c'est le même principe, et le code de ce module le chiffre : 0,81 point d'erreur sur les joueurs qu'il a vus, 0,74 point sur ceux qu'il n'a jamais vus. C'est le second chiffre qui a une valeur.
Le bon réflexe, qu'on installe dès maintenant et qu'on creusera au module sur la généralisation : mettre de côté une partie des joueurs (l'ensemble de test), entraîner sur le reste (l'ensemble d'entraînement), puis mesurer l'erreur sur ces joueurs jamais vus. Si l'erreur sur le test est proche de l'erreur sur l'entraînement, le modèle généralise : il a appris la tendance, pas les exemples. Si l'erreur de test augmente fortement, il a mémorisé. C'est le diagnostic le plus important de tout l'apprentissage supervisé, et tu le verras en chiffres dans le code.
Les pièges à connaître dès le départ
- Confondre erreur d'entraînement et vraie performance. Un modèle quasi parfait sur ses propres données d'entraînement ne dit rien de sa valeur sur du nouveau. C'est le piège numéro un.
- Vouloir un ε nul. Une part d'imprévisible existe toujours. Un modèle qui colle à 100 % aux données a, presque sûrement, appris le bruit, et c'est ce qu'on définira comme du sur-apprentissage.
- Corrélation prise pour causalité. Beaucoup de tirs vont avec beaucoup de points, mais ce sont souvent les bons scoreurs à qui on confie le ballon. Le modèle capte une association, pas forcément une cause. On garde ça en tête avant toute conclusion.
- Mal poser la question. Prédire et comprendre ne se travaillent pas pareil. La moitié des erreurs d'analyse viennent d'une question floue, pas d'un mauvais modèle.
Le code
Toute la démarche part des données. Chaque ligne de player_season.csv est un joueur-saison : son nombre de tirs tentés par match (fga_pg), ses points par match (ppg), ses minutes (min_pg), son efficacité (ts_pct).
Chaque ligne est une observation. La colonne fga_pg sera notre variable explicative (X), ppg notre cible (y). On a la bonne réponse (les points) pour chaque joueur : on est donc en apprentissage supervisé.
Comparons d'abord une règle écrite à la main et un modèle appris, sur la même question. La règle naïve dit « 1 tir = 1 point ». Le modèle, lui, apprend la relation qui colle le mieux aux 413 joueurs.
La règle de bon sens se trompe en moyenne de 2,27 points. Le modèle appris tombe à 0,79 point d'erreur, et il a découvert tout seul qu'un tir vaut environ 1,36 point (les lancers francs et les paniers à 3 points expliquent le surplus). Personne n'a écrit ce 1,36 : c'est la valeur qui minimise l'erreur sur l'ensemble des joueurs.
Maintenant, voyons ce que « prédire » veut dire concrètement : estimer la cible pour des cas que le modèle traite comme nouveaux.
Plus de tirs, plus de points, de façon régulière. Un joueur à 15 tirs est estimé à 20 points. C'est ça, prédire : appliquer la tendance apprise à un X donné. Le modèle ne sera jamais parfait pour autant : deux joueurs réels à 15 tirs ne marquent pas pareil (voilà le ε). L'objectif n'est pas la perfection, mais une estimation fiable.
Visualisons tout ça. Le nuage, ce sont les joueurs réels ; la courbe rouge, la relation apprise f(X) ; le point noir, notre prédiction à 15 tirs.
Le modèle a capturé un f : la courbe suit clairement le nuage. Et l'écart vertical entre chaque point et la courbe, c'est le résidu, la part de ε que ce seul tir tenté ne suffit pas à expliquer.
Dernier point, le plus important pour la suite : un modèle ne se juge pas sur les joueurs qui ont servi à l'apprendre. On en met de côté pour le tester comme s'ils étaient nouveaux.
L'erreur sur le test (0,74 point) est aussi basse que sur l'entraînement (0,81 point). Le modèle généralise : il a appris la tendance, pas la liste des joueurs. Si l'erreur de test avait explosé, on aurait eu affaire à un modèle qui mémorise. Garde ce réflexe, c'est la base de l'évaluation honnête qu'on construira au fil du parcours.
À toi de jouer
Reprends le code de la cellule 5, mais ajoute une deuxième variable explicative : les lancers francs par match. Remplace X = df[['fga_pg']] par X = df[['fga_pg', 'ft_pg']]. Garde random_state=42. Regarde si l'erreur de test descend sous les 0,74 point. À ton avis, pourquoi ajouter les lancers francs aide-t-il à prédire les points ? Tu verras qu'on passe sous 0,55 point : une information de plus, mieux choisie, vaut mieux qu'un modèle plus compliqué. C'est tout le programme des prochains modules.
Conclusion
On n'a écrit aucune règle, et le modèle a pourtant trouvé la relation entre la production d'un joueur et ses points : 0,79 point d'erreur, contre 2,27 points pour une règle de bon sens écrite à la main. C'est le renversement de l'apprentissage supervisé : on fournit des exemples avec leur réponse, et la règle sort des données. Le vocabulaire posé ici, observation, variables explicatives, cible, résidu et erreur irréductible, sert dans les treize modules qui suivent.
Ce que tu as appris
- Tu sais ce qu'est l'apprentissage supervisé : apprendre une relation
y ≈ f(X)à partir d'exemples avec leur bonne réponse, au lieu d'écrire les règles à la main. - Tu connais le vocabulaire qui structure tout le parcours : observation, variable explicative (X), cible (y), modèle, résidu, et l'erreur irréductible ε.
- Tu as vu, en chiffres, qu'un modèle appris (0,79 point d'erreur) bat une règle de bon sens (2,27 points), et pourquoi.
- Tu distingues supervisé et non supervisé, prédiction et inférence.
- Tu as installé le réflexe clé : on juge un modèle sur des données jamais vues, pas sur celles de l'entraînement.
Ce que ça change pour le basket
Tout ce que font aujourd'hui les services d'analyse repose sur cette idée : apprendre une relation à partir de saisons passées pour estimer l'avenir. Projeter le développement d'un jeune, chiffrer la valeur d'un joueur en vue d'un transfert, anticiper un résultat. Comprendre la différence entre prédire et comprendre, c'est savoir quelle question on pose avant de lancer un modèle compliqué. Et savoir qu'on doit tester sur des joueurs jamais vus, c'est ce qui sépare une vraie projection d'une illusion qui s'effondre dès la saison suivante.
Ce qui vient ensuite
Un modèle ne lit pas une table brute : il lui faut des nombres bien préparés. Le prochain module, « Des variables à la cible », montre comment transformer des box scores et des attributs de joueur (poste, taille, poids) en une matrice X et un vecteur y qu'un modèle peut réellement digérer, avec l'encodage des catégories et la mise à l'échelle.